Panne mondiale Microsoft 365 : pourquoi Outlook, Teams et Copilot restent instables après plus de 12 heures ?
Publié le
et mis à jour le
Rubrique Logiciels & Applications
Depuis jeudi 12 novembre en fin de matinée, heure de la côte Est américaine, un incident technique d’ampleur bouscule l’écosystème Microsoft 365 partout dans le monde. Outlook, Teams, SharePoint ou encore Copilot tournent au ralenti, quand ils ne sont pas tout simplement inaccessibles pour des dizaines de milliers d’internautes. En cause, selon l’éditeur, une série de serveurs qui ont décroché de manière inattendue après avoir échoué à des tests de santé automatisés, créant un effet domino sur le reste de l’infrastructure. Plus de douze heures après les premiers ratés, le retour à la normale n’est toujours pas acquis.
Une dégradation de service qui s’étire dans le temps
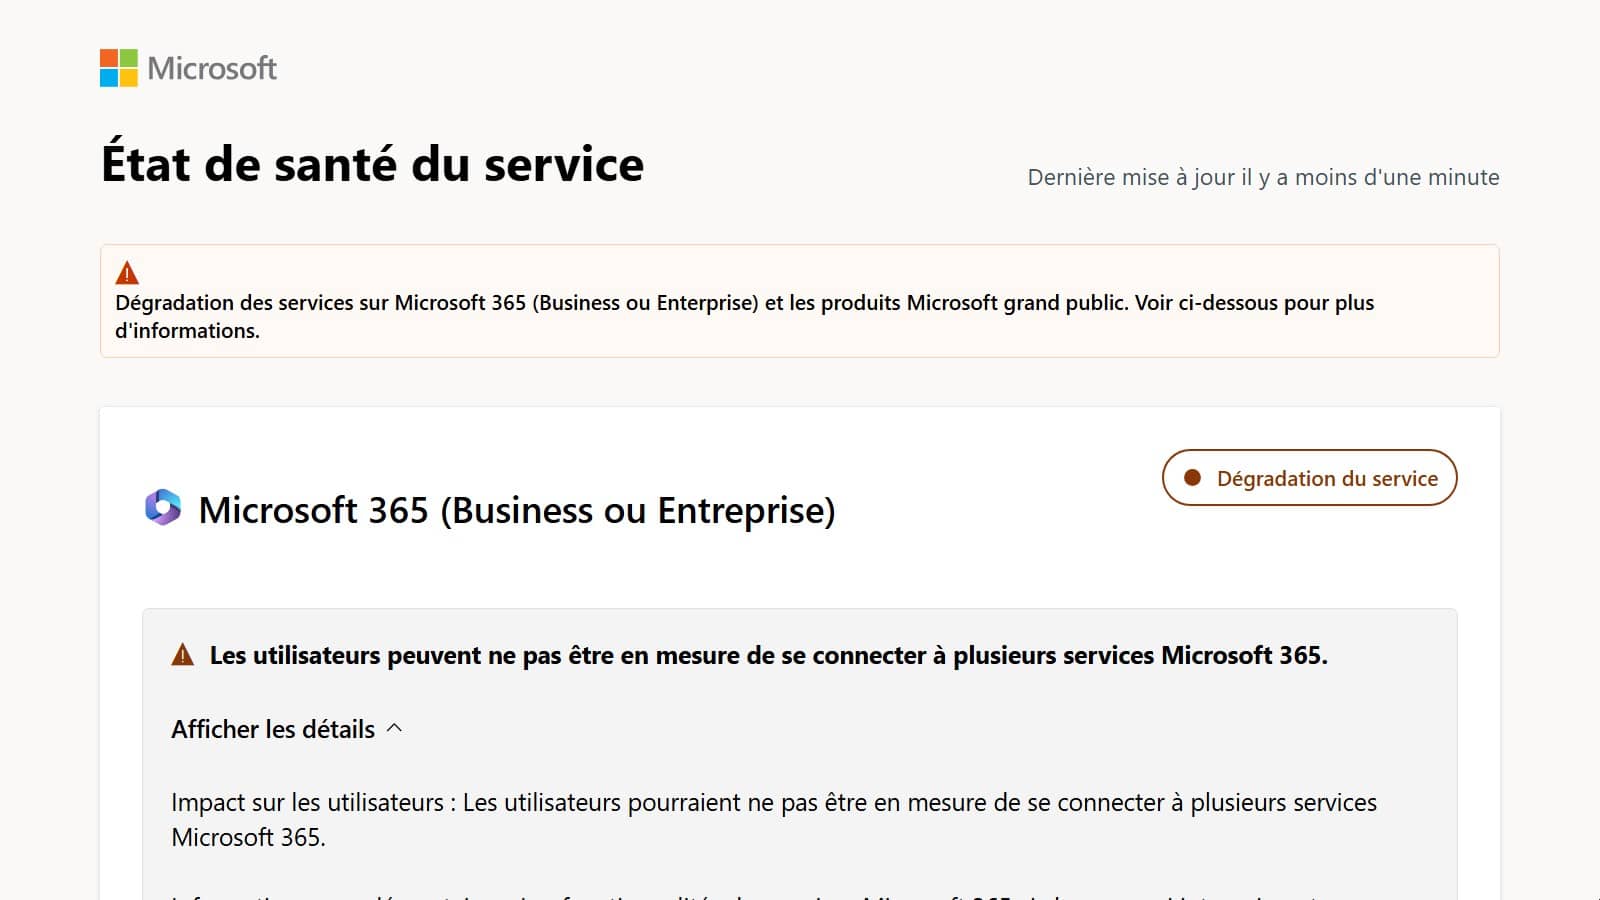
Si vous avez tenté de consulter vos courriels professionnels ou de lancer une visio ces dernières heures sans succès, vous n’êtes pas un cas isolé. Au moment où ces lignes sont écrites, la page officielle chargée de surveiller l’état des services de l’éditeur américain affiche toujours un bandeau d’alerte signalant une « dégradation de service ».
Le problème touche aussi bien les offres dédiées aux entreprises que les comptes utilisés par les particuliers. Sur la plateforme spécialisée Downdetector, la courbe des signalements a certes amorcé une descente par rapport au pic enregistré plus tôt, où l’on dépassait les 130 000 alertes rien que pour Outlook, mais le volume reste anormalement élevé dans de nombreux pays.
Des États-Unis à l’Europe, en passant par l’Australie, l’Inde ou le Japon, personne n’a vraiment été épargné. Face aux rumeurs qui enflent toujours très vite sur les réseaux sociaux dans ce genre de situation, Microsoft attribue l’incident à des défaillances de serveurs et n’a évoqué aucune piste de cyberattaque, même si la cause profonde n’a pas encore été publiée.
Publicité
Comment tout a déraillé autour d’Exchange Online
Pour comprendre ce qui coince, il faut remonter au jeudi 12 novembre, vers 11 h 17 sur la côte Est des États-Unis (17 h 17 à Paris). C’est à ce moment-là que les premiers grains de sable ont commencé à gripper la mécanique d’Exchange Online, la brique technique qui gère les messageries.
Très vite, la tache d’huile s’est étendue. Les ingénieurs maison ont d’ailleurs ouvert deux dossiers distincts pour suivre l’ampleur des dégâts : le ticket EX1550543 pour tout ce qui touche aux boîtes aux lettres, et le MO1550821 pour le reste de la suite bureautique.
D’après les explications techniques fournies par l’entreprise, un grand nombre de serveurs se sont subitement mis hors-jeu après avoir raté leurs contrôles de santé automatisés. Contrairement à ce que l’on pourrait penser au premier abord, ce n’est pas un afflux massif d’utilisateurs qui a fait plier les machines : c’est cette perte soudaine de capacité qui a forcé les serveurs encore debout à encaisser toute la charge de travail, provoquant une saturation en chaîne.
Un processus central sur ces machines s’est retrouvé complètement submergé, les rendant incapables de répondre aux requêtes. Par ricochet, tout ce qui dialogue avec la messagerie a été touché :
- Outlook (en version web, mobile et bureau)
- Microsoft Teams et SharePoint Online (pour les fonctions liées à la messagerie, comme le calendrier)
- L’assistant Microsoft 365 Copilot
- Les outils de sécurité Defender XDR
- Les applications Planner et To Do
La liste ne s’arrête pas là : Microsoft cite aussi des services comme Intune, Purview ou Power BI.
Un casse-tête technique aux airs de montagnes russes
Depuis le début de l’après-midi de jeudi outre-Atlantique, les équipes techniques livrent une véritable course contre la montre, avec des résultats en dents de scie. Au tout début, les responsables pensaient que l’incident se limitait aux Amériques, avant de devoir se rendre à l’évidence et d’élargir l’alerte à l’ensemble de la planète.
Durant l’après-midi et la soirée américaines, les ingénieurs ont enchaîné les manœuvres d’urgence : gel des déploiements, redémarrage ciblé des machines récalcitrantes, déplacement du trafic hors de l’infrastructure touchée et mise en place d’une méthode alternative pour vérifier l’état de santé des équipements.
Pendant un court laps de temps, ces efforts ont semblé payer et plusieurs serveurs ont repris du service normalement. Mais la joie a été de courte durée : dès que ces machines fraîchement relancées recevaient à nouveau du trafic, elles retombaient dans le coma informatique.
Les techniciens ont donc dû brider certains types de connexions pour soulager le réseau, tout en reconstruisant une partie des serveurs à partir d’une configuration antérieure jugée plus stable. En fin de soirée aux États-Unis, le ton des bulletins a changé : après avoir évoqué des « résultats positifs », le groupe a admis qu’un changement censé améliorer la situation ne produisait pas l’effet attendu.
Bureaux à l’arrêt et effets collatéraux inattendus
Sur le terrain, cette instabilité prolongée a mis les nerfs de nombreux travailleurs à rude épreuve. Quand la messagerie et l’outil de visioconférence flanchent en même temps, c’est toute l’organisation d’une journée de travail qui s’effondre.
En Australie, où la panne a frappé tôt vendredi matin, des établissements scolaires n’ont pas pu dispenser de cours à distance, et les services de renseignement comme la police fédérale ont été touchés. Aux États-Unis, des utilisateurs de la Chambre des représentants figurent aussi parmi les personnes affectées. Des administrations publiques et des services gouvernementaux ont ainsi dû composer avec ces ratés.
Plus surprenant encore, la secousse s’est fait sentir chez d’autres acteurs de la tech : les connecteurs permettant de lier les intelligences artificielles d’OpenAI et d’Anthropic aux espaces de travail Microsoft 365 ont eux aussi accusé le coup. Pour l’utilisateur lambda devant son écran, le constat était le même un peu partout : impossible d’envoyer un courriel urgent, calendrier qui tourne dans le vide, accès capricieux aux fichiers. Et même lorsque l’accès revenait brièvement, la connexion restait instable, variant d’un compte à l’autre sans logique apparente.
Une communication prudente mais sans calendrier précis
Tout au long de cette crise, la firme américaine a joué la carte de la transparence régulière, multipliant les points d’étape sur son compte X dédié (@MSFT365Status) ainsi que sur son portail de suivi. À chaque prise de parole, le message reste identique : les équipes sont mobilisées sur plusieurs fronts en parallèle pour redémarrer les serveurs de façon contrôlée, ajuster les protocoles de circulation des données et décortiquer la cause profonde qui a fait dérailler les fameux contrôles automatisés.
Cette communication rassure sur le fait que le problème est pris à bras-le-corps et qu’aucune piste malveillante n’est évoquée, mais elle laisse planer un flou total sur l’heure de fin des hostilités. Aucun délai précis n’a été avancé pour un retour complet à la normale, signe que la mécanique interne reste délicate à stabiliser.
Publicité
Faut-il s’attendre à de nouvelles coupures ?
À l’heure actuelle, la situation s’améliore par petites touches, mais de manière très inégale selon l’endroit où l’on se trouve. Si certains internautes ont retrouvé leurs outils habituels sans encombre, d’autres subissent encore des déconnexions intempestives. Tant que les serveurs n’auront pas retrouvé une stabilité à toute épreuve, le risque de voir l’incident repartir de plus belle lors des pics de connexion, notamment à la reprise du travail, reste bien réel.
Pour ceux qui subissent encore ces désagréments, il n’existe cependant pas de recette miracle. Les administrateurs informatiques conseillent simplement de garder un œil sur le portail status.cloud.microsoft pour suivre l’évolution en direct, d’éviter de relancer frénétiquement les applications toutes les dix secondes, et de basculer temporairement sur des messageries alternatives quand l’urgence l’exige. Inutile aussi de réinitialiser son mot de passe : le problème vient des serveurs de Microsoft.
Au-delà de l’agacement légitime d’une journée de travail gâchée, cet épisode rappelle une réalité parfois oubliée : notre quotidien numérique repose aujourd’hui sur quelques géants du cloud, et il suffit que l’un d’eux flanche pour que toute la chaîne en pâtisse.
Ce qu’il faut retenir :
- Plus de douze heures après le début d’une panne mondiale majeure sur Microsoft 365, des services essentiels comme Outlook, Teams, SharePoint et Copilot restent fortement instables ou inaccessibles.
- À l’origine du problème, une série de serveurs a décroché de façon inattendue après avoir échoué à des contrôles de santé automatisés, créant une surcharge en chaîne sur le reste de l’infrastructure.
- Microsoft a rapidement écarté la piste d’une cyberattaque, mais ses équipes peinent à stabiliser durablement les machines qui décrochent de nouveau dès qu’elles reçoivent du trafic.
- L’incident paralyse le quotidien de nombreuses entreprises, écoles et administrations à travers le monde, touchant même des outils tiers connectés comme ceux d’OpenAI et d’Anthropic.
- La récupération s’opère de manière lente et inégale selon les régions, et aucun délai précis n’a encore été communiqué par l’éditeur pour un retour complet à la normale.